


2026年11月12日に発生したMicrosoft 365の大規模障害について、Microsoftが11月16日に暫定的な原因分析を公表しました。
今回の障害では、OutlookやExchange Onlineをはじめ、Teams、Copilot、SharePoint、OneDriveなど、複数のMicrosoft 365サービスに影響が広がりました。
当初は通信設備の問題と説明されていましたが、今回の発表で、障害が発生した詳しい仕組みが明らかになっています。
原因は、7月から展開されていたネットワークゲートウェイ向けの修正プログラムに潜んでいた不具合でした。
さらに、Teamsの通信経路の切り替えと、サーバー容量の減少が重なったことで、不具合が表面化しました。
一部のサーバーが応答しなくなると、残りのサーバーに通信が集中し、最終的にはネットワークゲートウェイのサーバーの80%超が応答不能になる事態に発展しました。
今回は、Microsoftが公表した情報をもとに、障害が発生した原因と、なぜ世界規模に拡大したのかをできる範囲で分かりやすく解説してみます。
1. Microsoft 365の大規模障害で何が起きたのか?
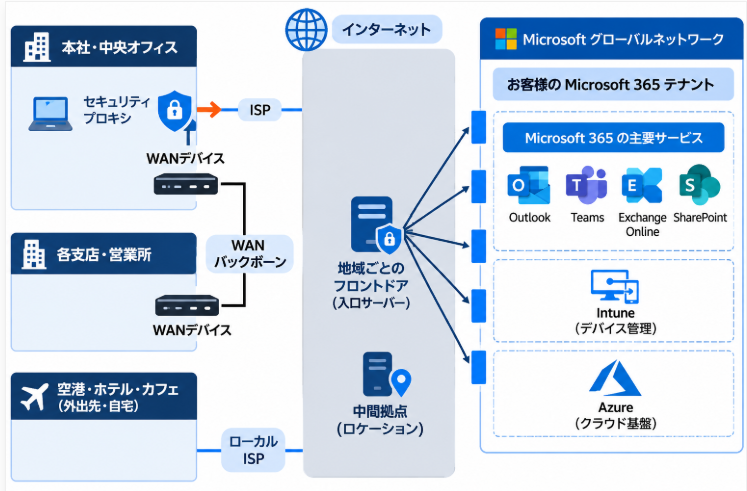
今回の障害は、Microsoft 365のサービスへの接続を中継する「ネットワークゲートウェイ」で発生しました。
ネットワークゲートウェイとは、利用者のパソコンやスマートフォンから送られてきた通信を、Microsoft 365の各サービスに届けるための中継地点です。
例えば、Outlookでメールを確認する場合、パソコンから送られた接続要求は、ネットワークゲートウェイを経由してExchange Onlineに届けられます。
つまり、ネットワークゲートウェイに問題が発生すると、メールサービスそのものが正常でも、利用者はメールにアクセスできなくなる可能性があります。

今回の障害では、次のようなサービスに影響が出ました。
| サービス | 主な影響 |
|---|---|
| Outlook | メールボックスに接続できない |
| Exchange Online | メールの送受信や閲覧に支障 |
| Teams | 一部機能に影響 |
| Copilot | Exchange Onlineに依存する機能などに影響 |
| SharePoint | 一部機能に影響 |
| OneDrive | 一部機能に影響 |
特に大きな影響を受けたのが、メールサービスのExchange Onlineです。
Microsoftの暫定報告書によると、障害は11月12日16時20分(UTC)に始まり、11月13日16時10分(UTC)に解消したとされています。日本時間では11月13日から14日にかけての約24時間に相当します。
2. 障害の原因は3つの問題が重なったこと
Microsoftは、今回の障害には大きく3つの要因があったと説明しています。
今回の障害を引き起こした3つの要因
① 7月の更新に潜んでいた不具合
特定の通信負荷がかかると、サーバー内部の処理が競合し、応答できなくなる問題。
② Teamsの通信経路の切り替え
Teamsの通信が別系統からExchange Onlineも利用する主要なゲートウェイに移り、負荷と通信パターンが変化。
③ サーバー容量が約14%減少
前日に発生した別の問題で、一部のサーバー容量が利用できない状態になっていた。
この3つの問題は、それぞれ単独であれば大規模障害につながらなかった可能性があります。
しかし、同時に発生したことで、潜在的な不具合が表面化しました。
原因① 7月の修正プログラムに不具合が潜んでいた
最初の原因は、2026年7月から世界中のネットワークゲートウェイに展開されていた修正プログラムです。
この修正プログラムには、特定の条件でサーバー内部の処理が競合する不具合が含まれていました。
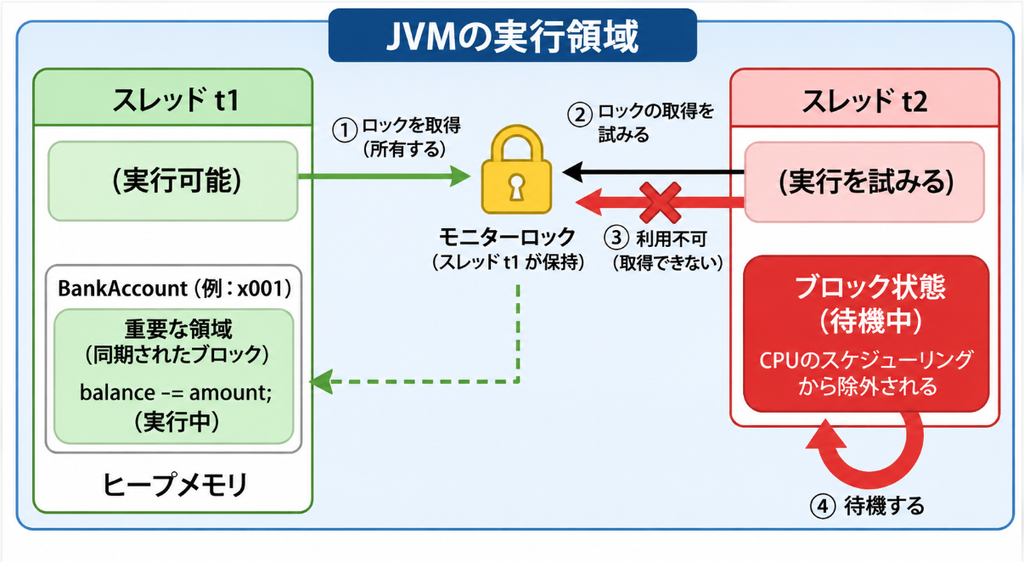
ここで重要になるのが「ロック競合(Lock Contention)」という仕組みです。
ロック競合とは、複数の処理が同じデータや処理領域を同時に使おうとしたときに、順番待ちが発生する現象です。
例えば、1つの窓口で複数の社員が同じ書類を処理しようとする場面を考えてください。
通常なら、順番に処理すれば問題ありません。
しかし、窓口の処理に不具合があると、待ち時間がどんどん長くなり、後から来た人の処理も進まなくなります。
今回の障害では、このような内部処理の競合によって、CPUやメモリなどのリソースが消費され、サーバーが応答できなくなったと説明されています。

では、なぜ7月に更新を配信したときには問題が発生しなかったのでしょうか?
Microsoftによると、事前の負荷試験で使用した機器と、実際に稼働していたサーバーの性能や通信パターンが異なっていたことが原因の一つです。
特に、試験では比較的コア数の少ない低性能な機器が中心でした。
ところが、実際の運用環境では、コア数が多く新しい機器ほど、この不具合が発生しやすかったといいます。
つまり、一般的には高性能なサーバーほど多くの処理をこなせますが、今回の不具合では、CPUコア数が多いことが逆に問題を悪化させる条件になっていました。
7月から3カ月以上も問題なく稼働していたため、Microsoftも不具合を発見できなかったのです。
なお、Microsoftは、この不具合と修正プログラムはMicrosoft 365のネットワークゲートウェイ専用であり、一般的なWindows環境には適用されないと説明しています。
原因② Teamsの通信経路が切り替わった
2つ目の原因は、Teamsの通信経路の切り替えです。
Microsoft 365には、障害が発生した場合などに備えて、2系統のネットワークゲートウェイが用意されています。
簡単にいうと、通常の通信経路と、障害時などに使う別の通信経路があるということです。

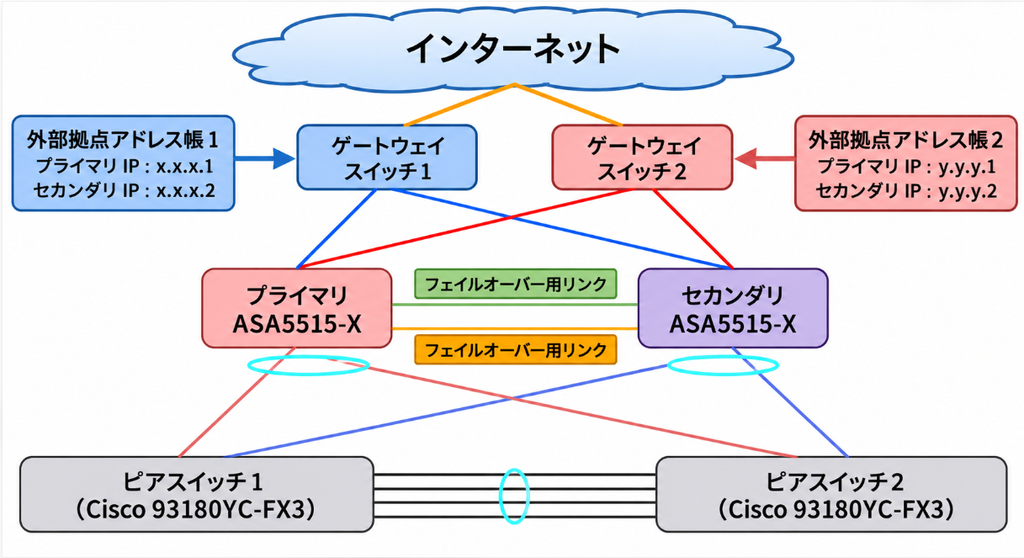
今回、障害が発生する約15時間前に、Teamsの通信が別系統のゲートウェイから、Exchange Onlineも利用する主要なゲートウェイに切り替わりました。
この切り替え自体は、システムの安定稼働を目的とした通常の運用でした。
しかし、切り替えによって主要なゲートウェイに流れる通信量が増加し、通信のパターンも変化しました。
その結果、7月から潜んでいた不具合が発生しやすい状態になってしまったのです。
つまり、通常ならサービスを守るための通信経路の切り替えが、今回は障害の引き金の一つになってしまいました。
原因③ サーバー容量が約14%減少していた
3つ目の原因は、ネットワークゲートウェイのサーバー容量が減少していたことです。
障害発生の前日、別の問題によって、ゲートウェイのサーバー容量の約14%が利用できない状態になっていました。
通常、サーバーは最大処理能力ぎりぎりで稼働させるのではなく、通信量が増えた場合に備えて余裕を持たせています。
例えば、100人の利用者を処理できるシステムで、普段は70人程度しか利用していないなら、30人分の余裕があります。
しかし、今回のように利用できるサーバー容量が14%減少していると、通信量が増えたときに余裕が少なくなります。
Microsoftによると、容量の減少だけなら問題はなかったとのことです。
しかし、そこにTeamsの通信経路変更による負荷増加と、7月の更新に潜んでいた不具合が重なったことで、サーバーが処理できなくなりました。
3. なぜサーバーの80%以上が応答不能になったのか?
今回の障害で特に問題だったのが、サーバーの停止が次々に広がったことです。
本来、ネットワークゲートウェイには、一部のサーバーが停止しても、残りの正常なサーバーに通信を振り分ける仕組みがあります。
この仕組みは、システムの可用性を高めるために使われる一般的な技術です。
しかし、今回はこの仕組みが逆効果になりました。
障害が広がる流れを整理すると、次のようになります。
障害が連鎖的に拡大した流れ
1.一部のサーバーが応答不能になる
7月の不具合が、通信量の増加によって表面化。
2.正常なサーバーに通信が集中する
停止したサーバーへの通信を、残りのサーバーに振り分ける。
3.残りのサーバーにも負荷が集中する
同じ不具合が発生し、さらにサーバーが停止。
4.障害が連鎖的に拡大する
通信を振り分けるたびに、正常なサーバーが減っていく。
5.サーバーの80%超が応答不能になる
2時間足らずで、ゲートウェイ基盤全体に影響が広がった。
最も深刻な時点
80%超
ネットワークゲートウェイのサーバーが応答不能に
さらに、Microsoftのネットワークゲートウェイには、障害が別の地域や区画に広がらないようにする仕組みもありました。
これは「バルクヘッド(隔壁)」と呼ばれる考え方です。
船の内部を複数の区画に分けておけば、一部に浸水しても、船全体が沈むことを防げます。
システムでも同じように、障害が発生した区画を切り離すことで、ほかの区画への影響を抑えます。
しかし、今回の障害では別の問題によって、この区画間の隔離機能も十分に働きませんでした。
そのため、一部のサーバーで発生した問題が、世界中のネットワークゲートウェイに広がってしまったのです。
4. なぜ再起動しても復旧できなかったのか?
通常、サーバーに問題が発生した場合は、再起動することで復旧できるケースがあります。
しかし、今回の障害では、再起動してもすぐに再び応答不能になる問題が発生しました。
原因は、処理できずに滞留していた通信要求です。
サーバーが停止している間にも、利用者からの接続要求は発生しています。
そのため、サーバーを再起動すると、待機していた通信が一斉に集中します。
ところが、根本的な不具合は解消されていないため、再び処理が競合し、サーバーが応答不能になってしまいます。
つまり、再起動だけでは問題を解決できなかったのです。
また、今回の不具合は7月の修正プログラムに潜んでいたため、直前に行った変更を取り消す通常の切り戻しでも簡単には復旧できませんでした。
Microsoftは最終的に、問題のある処理を以前の正常な状態に戻すための更新を作成しました。
そのうえで、サーバーを一定のグループごとにサービスから切り離し、修正プログラムを適用して再起動し、順番にサービスへ戻す方法を取りました。
単純にサーバーを再起動するのではなく、原因となった処理を修正してから段階的に復旧させたわけです。
5. なぜOutlookの復旧が遅れたのか?
今回、TeamsやOneDrive、SharePointなどは、問題が発生したネットワークゲートウェイを回避することで、比較的早く復旧できました。
しかし、Exchange Onlineは同じ方法で簡単に通信経路を切り替えることができませんでした。
そのため、Outlookのメールサービスは復旧に時間がかかりました。
ここで注意したいのは、Outlookそのもののソフトウェアが壊れたわけではないという点です。
Outlookは、Exchange Onlineに接続してメールを送受信する仕組みです。
その接続先や接続経路に問題が発生すれば、Outlookのアプリ自体が正常でもメールを確認できなくなります。
これは、クラウドサービスを利用する企業にとって重要なリスクです。
普段は意識することが少ないものの、複数のサービスが同じネットワーク基盤やクラウド基盤に依存している場合、一つの障害が複数の業務に影響する可能性があります。
6. 今回の障害から企業が学ぶべきこと
今回の障害は、サイバー攻撃やAIの暴走によって発生したものではありません。
Microsoftの説明では、ネットワークゲートウェイ向けのソフトウェアの不具合と、通信負荷、サーバー容量の問題が重なった技術的な障害です。
しかし、今回の事例から企業が学べることは少なくありません。
① クラウドサービスだけに業務を依存しない
Microsoft 365を利用している企業では、Outlook、Teams、SharePoint、OneDriveなどを日常業務の中心にしているケースが多いと思います。
しかし、クラウドサービスに障害が発生すると、普段使っている業務ツールが一斉に利用できなくなる可能性があります。
そのため、重要なメールやファイルは、会社のルールに従ってローカル環境や別のバックアップ先にも保存しておくことが重要です。
② Outlookが使えない場合の代替手段を用意する
例えば営業部門の場合、Outlookが使えなくなると、見積書の送付、納期回答、注文書の受領、顧客からの問い合わせ対応などに影響が出ます。
そのため、障害時に備えて次のような代替手段を決めておく必要があります。
| 業務 | 障害時の代替手段 |
|---|---|
| 顧客への緊急連絡 | 電話・携帯電話 |
| 社内連絡 | 電話・別系統の連絡手段 |
| 見積書の作成 | ローカルのExcel |
| 注文書の確認 | ローカル保存済みのPDF |
| 過去メールの確認 | PDF・MSGなどのバックアップ |
| 未対応案件の管理 | Excelの案件管理台帳 |
ただし、Teamsも同じ障害の影響を受ける可能性があるため、Teamsだけを代替手段にするのは不十分です。
③ メールのバックアップを自動化する
1人が1日に100件、150件以上のメールを送受信する企業では、重要なメールを手作業でPDFに変換して保存するのは現実的ではありません。
そのため、Outlookの自動保存機能などを活用して、メールを自動的に保存する仕組みを作ることが有効です。
例えば、次のような方法があります。
- 受信メール、送信メールを自動的に保存する
- 添付ファイルを別フォルダに保存する
- メール本文をPDF形式でも自動保存する
こうした仕組みがあれば、Outlookが起動しなくなった場合でも、保存済みのPDFや添付ファイルから必要な情報を確認できます。
7. まとめ:小さな不具合が世界規模の障害につながった
今回のMicrosoft 365大規模障害は、7月に展開された修正プログラムに潜んでいた不具合が、約3カ月後に表面化した事例でした。
そこにTeamsの通信経路変更と、サーバー容量の約14%減少が重なり、一部のサーバーが応答不能になりました。
さらに、停止したサーバーへの通信が正常なサーバーに集中し、障害が連鎖的に拡大。最も深刻な時点では、ネットワークゲートウェイのサーバーの80%超が応答不能になりました。
今回の障害で注目すべきなのは、単にソフトウェアに不具合があったことだけではありません。
- 事前の負荷試験で不具合を発見できなかった
- 通信経路の切り替えによって負荷が変化した
- サーバー容量が減少していた
- 障害を区画内に閉じ込める仕組みが機能しなかった
- 再起動だけでは復旧できなかった
こうした複数の問題が重なったことで、世界規模の障害に発展しました。
クラウドサービスは非常に便利ですが、どれだけ大手企業のサービスであっても、障害が発生する可能性はあります。
企業としては、クラウドサービスの利用を前提としながらも、万が一利用できなくなった場合に業務を継続できる仕組みを準備しておくことが重要です。
Microsoft 365を日常業務の中心にしている企業ほど、今回の障害をきっかけに、自社のバックアップ体制等を見直してみてはいかがでしょうか。