


今回のマイクロソフトの大規模障害は、簡単に言うと、サーバーの処理能力を増やすために行った通信設備の増強作業に問題があり、その影響で世界中のMicrosoft 365のサービスが正常に動かなくなったというものです。
Outlookメインで使っている方は、メールの送受信ができず、電話・FAXを使ったり、社内同士はTeamsを使ったり、代替手段で乗り切った方も多いと思います。
過去のメールも閲覧できず、空いた時間にやれることにも制限が出てしまいました。
Excelは開けたので、たまった文書や資料の作成は捗った方もいたようです。
それはさておき、今回の件で重要だと思うのは、今回の原因がサイバー攻撃でも、AIの暴走でもなく、マイクロソフト側のシステム設備の管理・変更作業にあったという点です。
少し技術的な話も交えながら、順番に説明してみます。
1. そもそも何が起きたのか?
2026年11月12日、Microsoft 365で大規模なシステム障害が発生しました。
影響を受けた主なサービスは次のとおりです。
- Outlook:メールの送受信などに支障
- Teams:オンライン会議やチャットなどに支障
- Copilot:生成AIサービスにも影響
- その他のMicrosoft 365関連サービス
日本だけでなく、世界各地で障害が発生しました。
つまり、特定のパソコンや会社のネットワークが故障したのではなく、世界中の利用者が接続しているマイクロソフト側のクラウドサービスに問題が発生したわけです。
2. 本当の原因は何だったのか?
今回の障害は、次のような流れで発生したと考えられています。
障害発生のメカニズム
- 通信設備の処理能力を増強
マイクロソフトは、世界中から届く大量の通信を処理するため、過去にネットワーク設備の増強作業を行っていました。 - 増強作業に問題が残っていた
このときの作業に技術的な問題がありました。ただし、具体的にどの設定や設備が不適切だったのかは、まだ詳細な調査報告を待つ必要があります。 - その後のネットワーク変更で問題が表面化
別のネットワーク変更をきっかけに、以前から潜在していた問題が表面化しました。 - 一部のサーバーが正常に動かなくなった
サーバーが次々と利用できない状態になり、残ったサーバーに処理が集中しました。 - 残ったサーバーにも負荷が集中
通常の通信量であっても、処理できるサーバーが減っていたため、負荷に耐えられなくなり、さらにサーバーが停止するという悪循環に陥りました。
ここで重要なのは、利用者が急増してサーバーがパンクしたわけではないという点です。
マイクロソフトの説明では、通信量そのものが急増したのではなく、サーバーが予想外に利用できなくなったことで、残った設備に負荷が集中したとされています。
3. なぜ一部のサーバーが止まると、世界中に影響するのか?
ここが今回の障害で特に興味深いところです。
例えば、100台のサーバーで仕事を処理している会社があるとします。

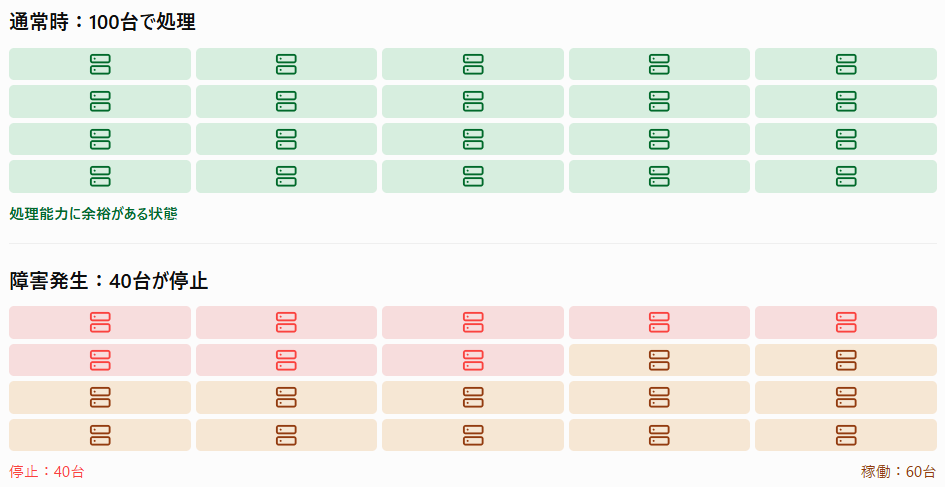

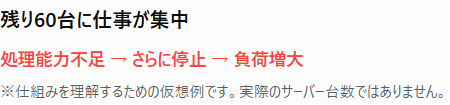
本来なら、停止したサーバーの仕事を残りのサーバーが引き受ければよいはずです。
しかし、残りのサーバーにも限界があります。
今回の障害では、さらに厄介な問題がありました。
サーバーを再起動しても、すぐに直らなかった
マイクロソフトは障害が発生したサーバーを再起動して復旧を試みました。
ところが、再起動したサーバーは一時的に正常に見えても、大量の通信を受けると再び応答できなくなるケースがありました。
原因の一つとして、サーバーが安全な通信を確立するための処理が過負荷になっていたことが報じられています。
また、復旧時に大量の接続要求が一気に押し寄せる「サンダリングハード(Thundering Herd)」と呼ばれる現象も、復旧を難しくしたとマイクロソフト側が説明しています。
簡単に言うと、
- サーバーが停止する
- 再起動する
- 利用者からの接続要求が集中する
- 再び処理能力を超えてしまう
- また停止する
という状態です。
そのため、マイクロソフトは一度にすべてを復旧させるのではなく、通信を少しずつ戻しながら、安定して動作するかを確認していきました。
4. なぜOutlookだけでなくTeamsやCopilotまで停止したのか?
ここには、クラウドサービスの重要な仕組みがあります。
実は、Outlook、Teams、Copilotは、それぞれ独立して動いているわけではありません。
Microsoft 365のサービス構造(概念図)

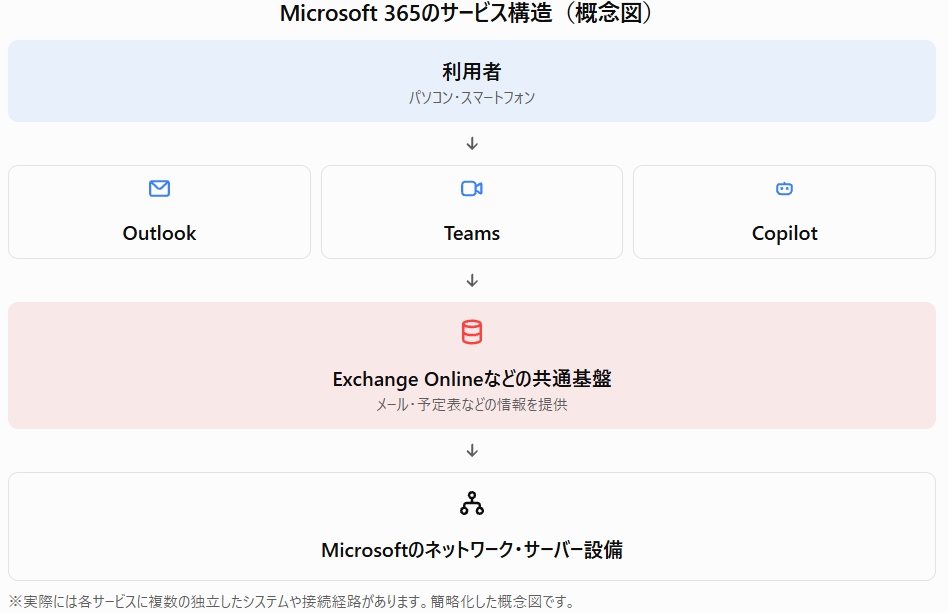
例えば、Teamsで会議の予定を確認する場合、Exchange Onlineに保存された予定表の情報を利用します。
Copilotで「昨日届いたメールの内容をまとめて」と依頼した場合も、Microsoft 365のメール情報にアクセスする必要があります。
つまり、Outlookが正常に動かなくなるような共通基盤の障害が発生すると、TeamsやCopilotなどにも影響が広がる可能性があるのです。
今回の障害では、こうした依存関係によって影響範囲が広がりました。
5. 今回の障害から学べること
今回のニュースで、特に企業のIT管理という観点から、3つの教訓があると思います。
① 設備増強作業にもリスクがある
一般的に、設備増強はシステムを強くするために行います。
しかし、設備を増強したり、ネットワーク設定を変更したりする作業そのものが、新たな障害の原因になることがあります。
今回のように、作業時には問題が表面化せず、後日の別の変更をきっかけに障害が発生することもあります。
そのため、変更作業では次の管理が重要ではないでしょうか。
- 変更前の設定を保存する
- 変更内容と作業者を記録する
- 一部の環境で事前検証する
- 問題が発生した場合に元に戻せるようにする
- 変更後も一定期間監視する
② クラウドサービスに依存しすぎない
例えば、会社の業務が次のようになっていたとします。
- メールはOutlook
- 会議はTeams
- ファイル管理はOneDrive
- 情報検索はCopilot
- スケジュール管理はOutlook
これらをすべてMicrosoft 365に依存していると、今回のような障害が発生した際、会社の業務が一斉に止まる可能性があります。
システムを複数に分けるより、一元化した方が作業、管理、共にスムーズになりますが、今回は一元化のデメリットが表に出てしまいました。つまり、一つ止まると全部止まる。
対策としては、緊急時の連絡手段、重要データのバックアップ、代替業務手順などを準備しておく必要があるのではないでしょうか。
③ AIを導入しても、基盤となるシステムが止まれば使えない
今回、Copilotも影響を受けました。
AIがどれだけ賢くなっても、AIが利用するメール、ファイル、データベース、ネットワークなどが停止すれば、業務を継続できません。
外部委託すると、社内の負担は軽減されますが、外部が止まると社内も止まってしまいます。
これはCopilotに限らず、ChatGPTなどの外部AIと企業のMicrosoft 365を連携させる場合にも考えておくべき問題と思われます。
6.まとめ
今回の出来事を整理すると、次のようになります。
| 項目 | 内容 |
|---|---|
| 発生原因 | 過去のネットワーク容量増強作業の問題 |
| 発生のきっかけ | その後のネットワーク変更 |
| 直接的な問題 | サーバーの利用不能・処理能力低下 |
| 障害の拡大 | 残存サーバーへの負荷集中 |
| 復旧を難しくした要因 | 再接続時の負荷集中など |
| サイバー攻撃 | 否定 |
| AIの暴走 | 否定 |
| 復旧 | 11月14日に全面復旧を発表 |
なお、現時点ではマイクロソフトの詳細な事後報告書はまだ公表されていません。したがって、増強作業で具体的にどの設定や設備に問題があったのかは、今後の報告を確認する必要があります。
今回のニュースで最も重要だと思うことは、AI時代になっても、ITシステムの安定性を左右するのは、AIの賢さだけではないということです。
どれだけ優れたAIを導入しても、そのAIが利用するネットワーク、サーバー、データベース、認証システムなどが止まれば、業務は止まります。
むしろ、これから企業がAIを積極的に導入するほど、こうした共通基盤への依存度は高まっていきます。
AIの導入を考えるときには、AIが何をできるかだけでなく、AIが使えなくなったときに会社の仕事をどう継続するかまで考える必要があるということではないでしょうか。